Der Dokumentendaten-Engpass bei KI in Unternehmen
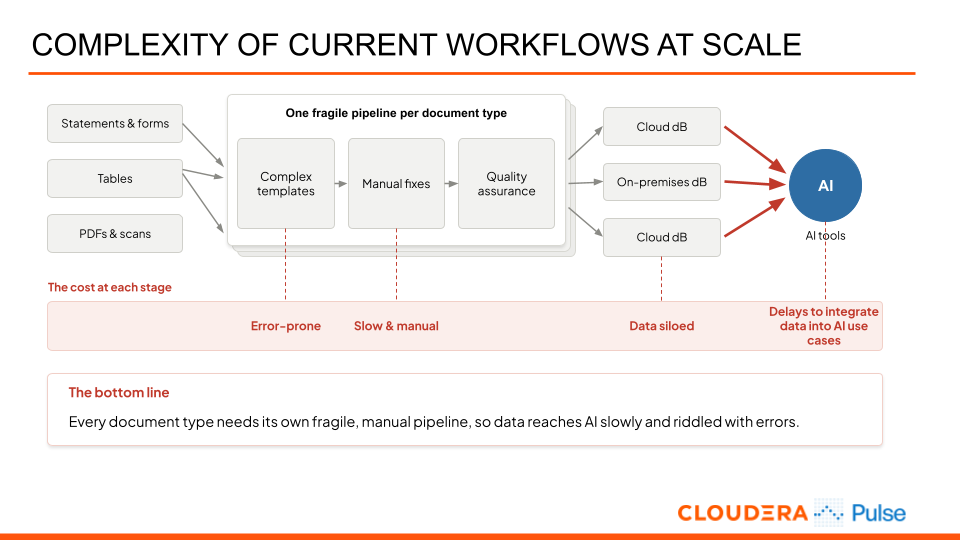
Während unstrukturierte Daten etwa 80 % der gesamten Unternehmensdaten ausmachen, werden sie in Datenanalyse- und KI-Anwendungsfällen nur unzureichend genutzt. Unternehmen sehen sich mit einer Flut komplexer PDFs und gescannter Dokumente konfrontiert, die herkömmliche Tools zur optischen Zeichenerkennung (OCR) und große Sprachmodelle (LLMs) bei der präzisen Verarbeitung in großem Umfang vor Herausforderungen stellen. Der herkömmliche Ansatz stützt sich stark auf anfällige, vorlagenbasierte OCR, die bei variierenden Dokumenten, Handschrift oder schlechten Scans versagt und zu erheblichen Engpässen bei der manuellen Überprüfung führt. Allgemeine LLMs hingegen verlieren häufig die Dokumentstruktur, lassen Quellenangaben vermissen und bergen ein erhebliches Risiko, Werte zu halluzinieren. Darüber hinaus bleiben kritische Daten in architektonischen Silos gefangen, die durch fragmentierte, grob abgestufte Sicherheitsmodelle gekennzeichnet sind.
Diese Herausforderungen verhindern die Integration von Dokumentdaten in KI-Anwendungsfälle aufgrund hoher Fehlerraten, die regulatorische Risiken bergen können (z. B. ein falsch gelesenes Deckungslimit in einer Schadensakte, das rechtliche Risiken birgt), und hoher Stückkosten für die Dokumentenextraktion und -verarbeitung, die die Übernahme hochvolumiger Dokumentdaten in AI/ML-Anwendungsfälle einschränken. Darüber hinaus führen manuelle Prüfungen, disparate Datensilos mit heterogenen Schemas und unterschiedliche Mechanismen für die Sicherheitsgovernance zu Verzögerungen bei der Bereitstellung dieser Daten für AI/ML-Anwendungsfälle – angesichts der zahlreichen ETL-Pipelines, die erforderlich sind, um extrahierte Ausgaben unter einem gemeinsamen Schema zu standardisieren und in Features umzuwandeln.
Die Partnerschaft zwischen Cloudera und Pulse: Eine Referenzarchitektur für Dokumenten-KI in großem Umfang
Cloudera und Pulse arbeiten zusammen, um Dokumente in großem Maßstab zu extrahieren und zu verarbeiten und dabei die Einschränkungen herkömmlicher Ansätze zu überwinden:
Pulse ersetzt mehrere Datenextraktionspipelines für komplexe PDFs, handschriftliche Notizen, Tabellen und Diagramme durch eine einzige mehrstufige Pipeline mit mehreren Modellen, die hochpräzise, auditfähige Daten liefert. Jeder Datenextraktionsschritt wird von einem Modell ausgeführt, das genau für diese Aufgabe entwickelt wurde, und das „Pulse Brain“ kann den semantischen Kontext und das Dokumentlayout verstehen und die Ergebnisse analysieren, um Fehler vor der Ausgabe zu erkennen.
Cloudera bietet eine zentralisierte, offene Data-Lakehouse- und Unternehmens-KI-Plattform, die Datenstreaming, Data Engineering, Data Warehousing sowie ML/GenAI in großem Maßstab mit einer einheitlichen Sicherheits- und Governance-Ebene über SDX integriert. Dieses Framework bietet attributbasierte Datenzugriffskontrollen, Herkunftsnachverfolgung sowie aktive Metadatenanreicherung und -katalogisierung.
Diese Kombination schafft eine einheitliche Technologiearchitektur, die strukturierte und unstrukturierte Dokumentdaten (verarbeitet über Pulse) in einem gemeinsamen Sicherheits- und Governance-Framework zusammenführt und über eine zentrale, transparente Sicht verschiedene öffentliche und private Cloud-Umgebungen hinweg integriert. Die Architektur ermöglicht die Standardisierung von Feature-Engineering-Workflows über unterschiedliche und vielfältige Datenquellen hinweg und die Verknüpfung strukturierter Daten mit Dokumentdaten in AI/ML-Anwendungsfällen. Darüber hinaus bietet sie eine einheitliche Datenschicht für den Datenaustausch, die strukturierte Daten und Dokumentdaten für externe Tools vor Ort oder in der Cloud bereitstellt.
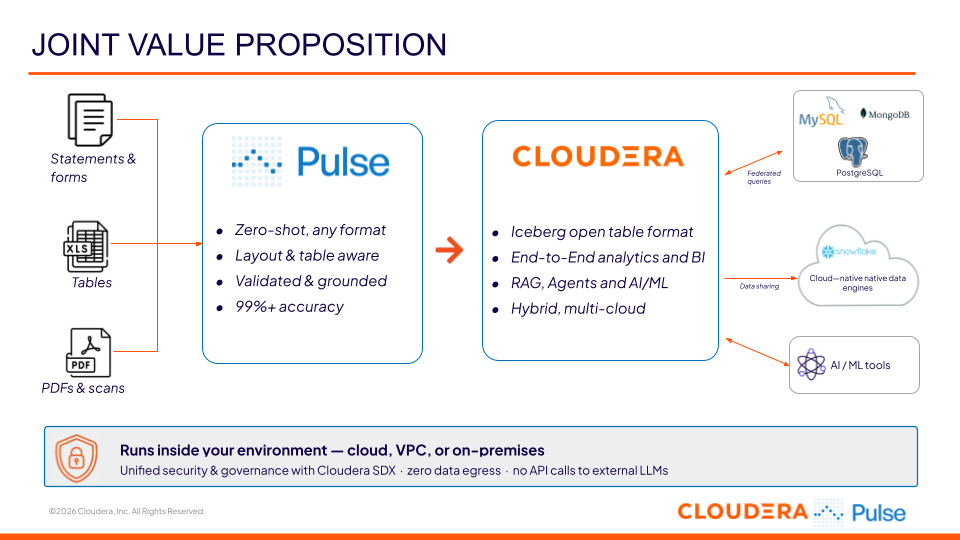
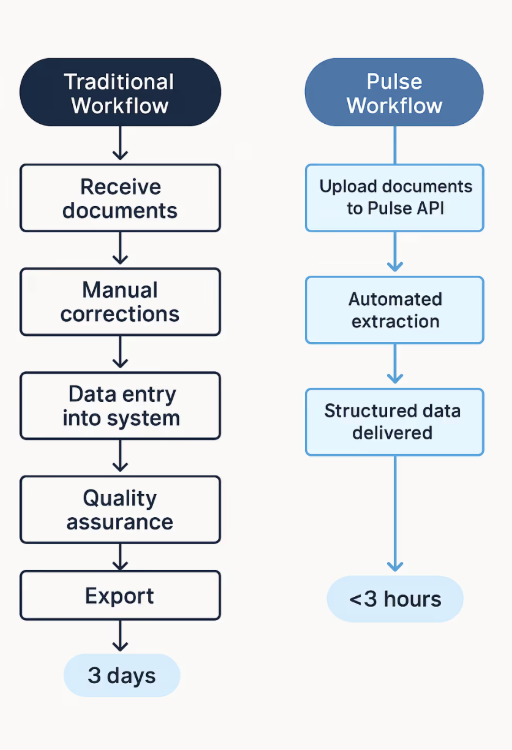
Darüber hinaus verkürzt das gemeinsame Wertversprechen die Zeit für die Integration von Dokumentendaten in KI-Anwendungsfälle, indem es manuelle Korrekturen und Qualitätssicherungsaufgaben eliminiert, die normalerweise bis zu drei Tage in Anspruch nehmen würden, und so den Extraktionszeitraum auf weniger als drei Stunden verkürzt:
Cloudera liefert Verbesserungen bei Data Engineering und LLM-Inferenz-Workloads von bis zu 20x bzw. 36x. Ebenso setzt Pulse mehrere GPU- und CPU-Optimierungen ein, um die Stückkosten für die Extraktion zu minimieren, und steigert so die GPU-Auslastung um 30 %.
Entwickelt für sensible Daten und regulierte Branchen
In regulierten Branchen wie Finanzdienstleistungen und dem Gesundheitswesen werden die Kosten eines unbemerkten Extraktionsfehlers in Millionenhöhe oder regulatorischen Risiken gemessen, anstatt nur ein einfaches Qualitätsproblem darzustellen. So könnte beispielsweise ein falsch gesetzter Dezimalpunkt oder ein als Komma interpretierter Punkt zu erheblichen Fehlern bei der AML/KYC-Überprüfung führen, was empfindliche behördliche Geldbußen nach sich ziehen kann.
Die Lösung von Cloudera und Pulse wurde explizit für sensible Daten und regulierte Branchen konzipiert; sie kann vollständig in der virtuellen privaten Cloud (VPC) eines Kunden bereitgestellt werden, ohne öffentlichen Datenausgang für die Dokumentenextraktion oder erweiterte Analysen.
Pulse bietet einen produktionsreifen Ansatz zur Überprüfbarkeit von Daten, indem sichergestellt wird, dass jedes extrahierte Feld direkt auf seinen exakten Ort auf der Quellseite zurückgeführt werden kann. Dabei bleiben der Kontext und die hierarchischen Beziehungen erhalten, die eine nahezu fehlerfreie Dokumentenextraktion gewährleisten. Speziell für Tabellendaten kann Pulse Layout, Formatierungskonventionen und finanzspezifische Nuancen erfassen, um die Einschränkungen herkömmlicher Ansätze zu überwinden (z. B. das Weglassen ausgeblendeter Spalten, den Umgang mit hierarchischen Daten usw.).
Das offene Data Lakehouse von Cloudera bietet über SDX einen detaillierten Datensicherheitsmechanismus, der strenge regulatorische Anforderungen erfüllt, wie beispielsweise GxP-Konformität im Bereich Life Sciences. Cloudera Data Lineage verfolgt tiefgehende strukturelle Datenbeziehungen vom rohen gescannten Dokument bis hin zu Vektordatenbankeinträgen und erstellt so Compliance-konforme Nachverfolgungsdatensätze.
Als Kräfteverstärker für KI-Initiativen
Das gemeinsame Wertversprechen ist besonders relevant für KI-Initiativen, da die Fähigkeiten von KI-Modellen zunehmend zur Ware werden und sich der wahre Wettbewerbsvorteil eines Unternehmens drastisch von reinem Modellzugriff hin zu proprietären Daten verlagert hat. Cloudera und Pulse helfen Unternehmen, diesen enormen Wettbewerbsvorteil sicher zu erschließen, indem sie unstrukturierte Dokumentenarchive in hochwertige, handlungsrelevante Datenbestände umwandeln. Gemeinsam verbessern Cloudera und Pulse die semantische Genauigkeit von Vektorsuchen in Cloudera RAG Studio erheblich und verwandeln hochsensible, proprietäre Dokumentendatenbanken in eine umfassende Grundlage für sichere Business Intelligence und fortschrittliche agentische Pipelines.
Geschäftswert in großem Umfang erzielen
In Unternehmensbereitstellungen hat Pulse im Vergleich zu herkömmlichen Dokumentenextraktionsansätzen beispiellose Ergebnisse erzielt.
Für ein führendes Energieversorgungsunternehmen digitalisierte es 1,2 Mio. handschriftliche Außendienst-Dokumente und erzielte dabei eine Genauigkeit von 97,5 % bei Daten, die jahrzehntelang von keinem System zuverlässig digitalisiert werden konnten. Für einen führenden Versicherungsmakler war es das erste System, das bei Dokumentdaten, die von mehreren Offshore-Teams verarbeitet wurden, durchgängig eine Genauigkeit von 99 % erzielte. Dadurch verkürzte sich die Zeit für die Entwicklung einer vollständigen, prüffähigen strukturierten Ausgabe um 76 %.
Erfahren Sie mehr über die Fähigkeiten von Cloudera und die Pulse-Plattform.