Unternehmen treiben mit Hochdruck den Einsatz hochgradig wertvoller, differenzierter KI-Agenten in der Produktion voran. Doch die wertvollsten Agenten sind auf Daten angewiesen, bei denen sich Unternehmen einen Kontrollverlust am wenigsten leisten können: sensible, proprietäre Daten.
Das stellt eine unmittelbare Governance-Herausforderung dar. In vielen traditionellen Architekturen müssen Agenten Daten aus dem verwalteten Speicher in externe SaaS-Plattformen verschieben, bevor sie sie nutzen können. Sobald dies geschieht, verlieren Unternehmen die Möglichkeit, die Daten vollständig an ihrer Quelle zu steuern, und übernehmen drei sich verstärkende Risiken:
Sicherheit: Jeder Export erstellt eine externe Kopie sensibler Daten, vergrößert dadurch die Angriffsfläche und zwingt Teams, einen parallelen Datensatz getrennt von ihrer zentralen Datenquelle zu verwalten, zu patchen und zu prüfen.
Leistung: Das Hin- und Zurückübertragen von Daten zu einer externen Plattform verursacht Latenz und hebt die in den verwalteten Speicher integrierten Abfrageoptimierungen auf, sodass Agenten deutlich langsamer laufen, als es die zugrunde liegende Infrastruktur ermöglicht.
Kosten: Das Extrahieren von Daten über Cloud-Grenzen hinweg in großem Umfang treibt die Egress-Gebühren in die Höhe – oft unvorhersehbar, da Agenten-Workloads Daten wiederholt statt nur einmal abfragen.
Die Daten und KI, die wir für einen wirklich differenzierten Mehrwert benötigen, bergen oft das größte Risiko, wenn sie unserer Kontrolle entgleiten. Infolgedessen sehen sich Compliance- und Sicherheitsteams, die genau diese Risiken bewerten, häufig gezwungen einzugreifen und vielversprechende Initiativen zu stoppen, sobald diese die Proof-of-Concept-Phase erfolgreich abgeschlossen haben.
Die fünf strukturellen Hürden für produktionsreife KI
Im Kern können agentische Workflows – die Reasoning-LLMs mit Tool-Schnittstellen, strukturierter Aufgabenplanung und kontinuierlichen Ausführungsschleifen kombinieren – nicht sicher auf isolierter Infrastruktur betrieben werden. Sie benötigen direkten Zugriff auf Rechenressourcen für verwaltete Datengrundlagen. Wenn Unternehmen gezwungen sind, fragmentierte Setups mit Datenverschiebungen zu nutzen, stoßen sie auf fünf konkrete Hindernisse:
Black-Box-Autonomie und Audit-Haftungsrisiken: Autonome mehrstufige Entscheidungen bergen regulatorische Risiken. Die standardmäßige Systemprotokollierung erfasst Aufrufe von Endpunkten, lässt jedoch die interne Aufgabenplanung von Subagenten, die Eingaben und Ausgaben spezifischer Tool-Payloads sowie die authentifizierte Benutzeridentität hinter jedem Schritt außer Acht.
Governance-Drift in Teams mit Silostrukturen: Wenn Business-Teams visuelle Prototypen in nicht überwachten SaaS-Tools erstellen, während Engineers in separaten Umgebungen benutzerdefinierte Python-Orchestrierungsskripte schreiben, kommt es zu einer Aufspaltung der technischen Architektur. Diese Dualität umgeht zentrale Zugriffskontrollen und führt zu Governance-Drift.
Fragiles Prompting und Wiederholungen bei der Ausführung: Traditionelle Agenten-Frameworks weisen Modelle mithilfe unstrukturierter Text-Prompts an. Wenn ein LLM Freitext statt strukturierter Payload-Schemas ausgibt, brechen Ausführungsketten ab. Wiederholungsversuche des Systems verbrauchen zusätzliche API-Token, erhöhen die Abfragelatenz und verursachen Fehler in mehrstufigen Ausführungspfaden.
Cloud-Egress-Gebühren und Token-Inflation: Das Extrahieren operativer Datensätze über Cloud-Grenzen hinweg zu externen Hosts verursacht wiederkehrende Daten-Egress-Gebühren. Die Übergabe unstrukturierter, nicht kuratierter Kontexte an externe LLM-Kontextfenster erhöht bei jeder Abfrage den Token-Verbrauch und steigert dadurch die Inferenzkosten pro Abfrage, ohne die Schlussfolgerungsgenauigkeit zu verbessern.
API-Abhängigkeit und feste Rechenkosten: Die Festcodierung der Orchestrierungslogik auf proprietäre Modell-APIs bindet Unternehmen an feste Preise für Rechenleistung. Infrastrukturteams verlieren die Flexibilität, Routine-Funktionsaufrufe an kostengünstigere lokale Parametermodelle weiterzuleiten und gleichzeitig APIs führender Drittanbieter für komplexe Argumentationsaufgaben zu reservieren.
Wie Cloudera Agent Studio eine Governance-konforme Ausführung ermöglicht
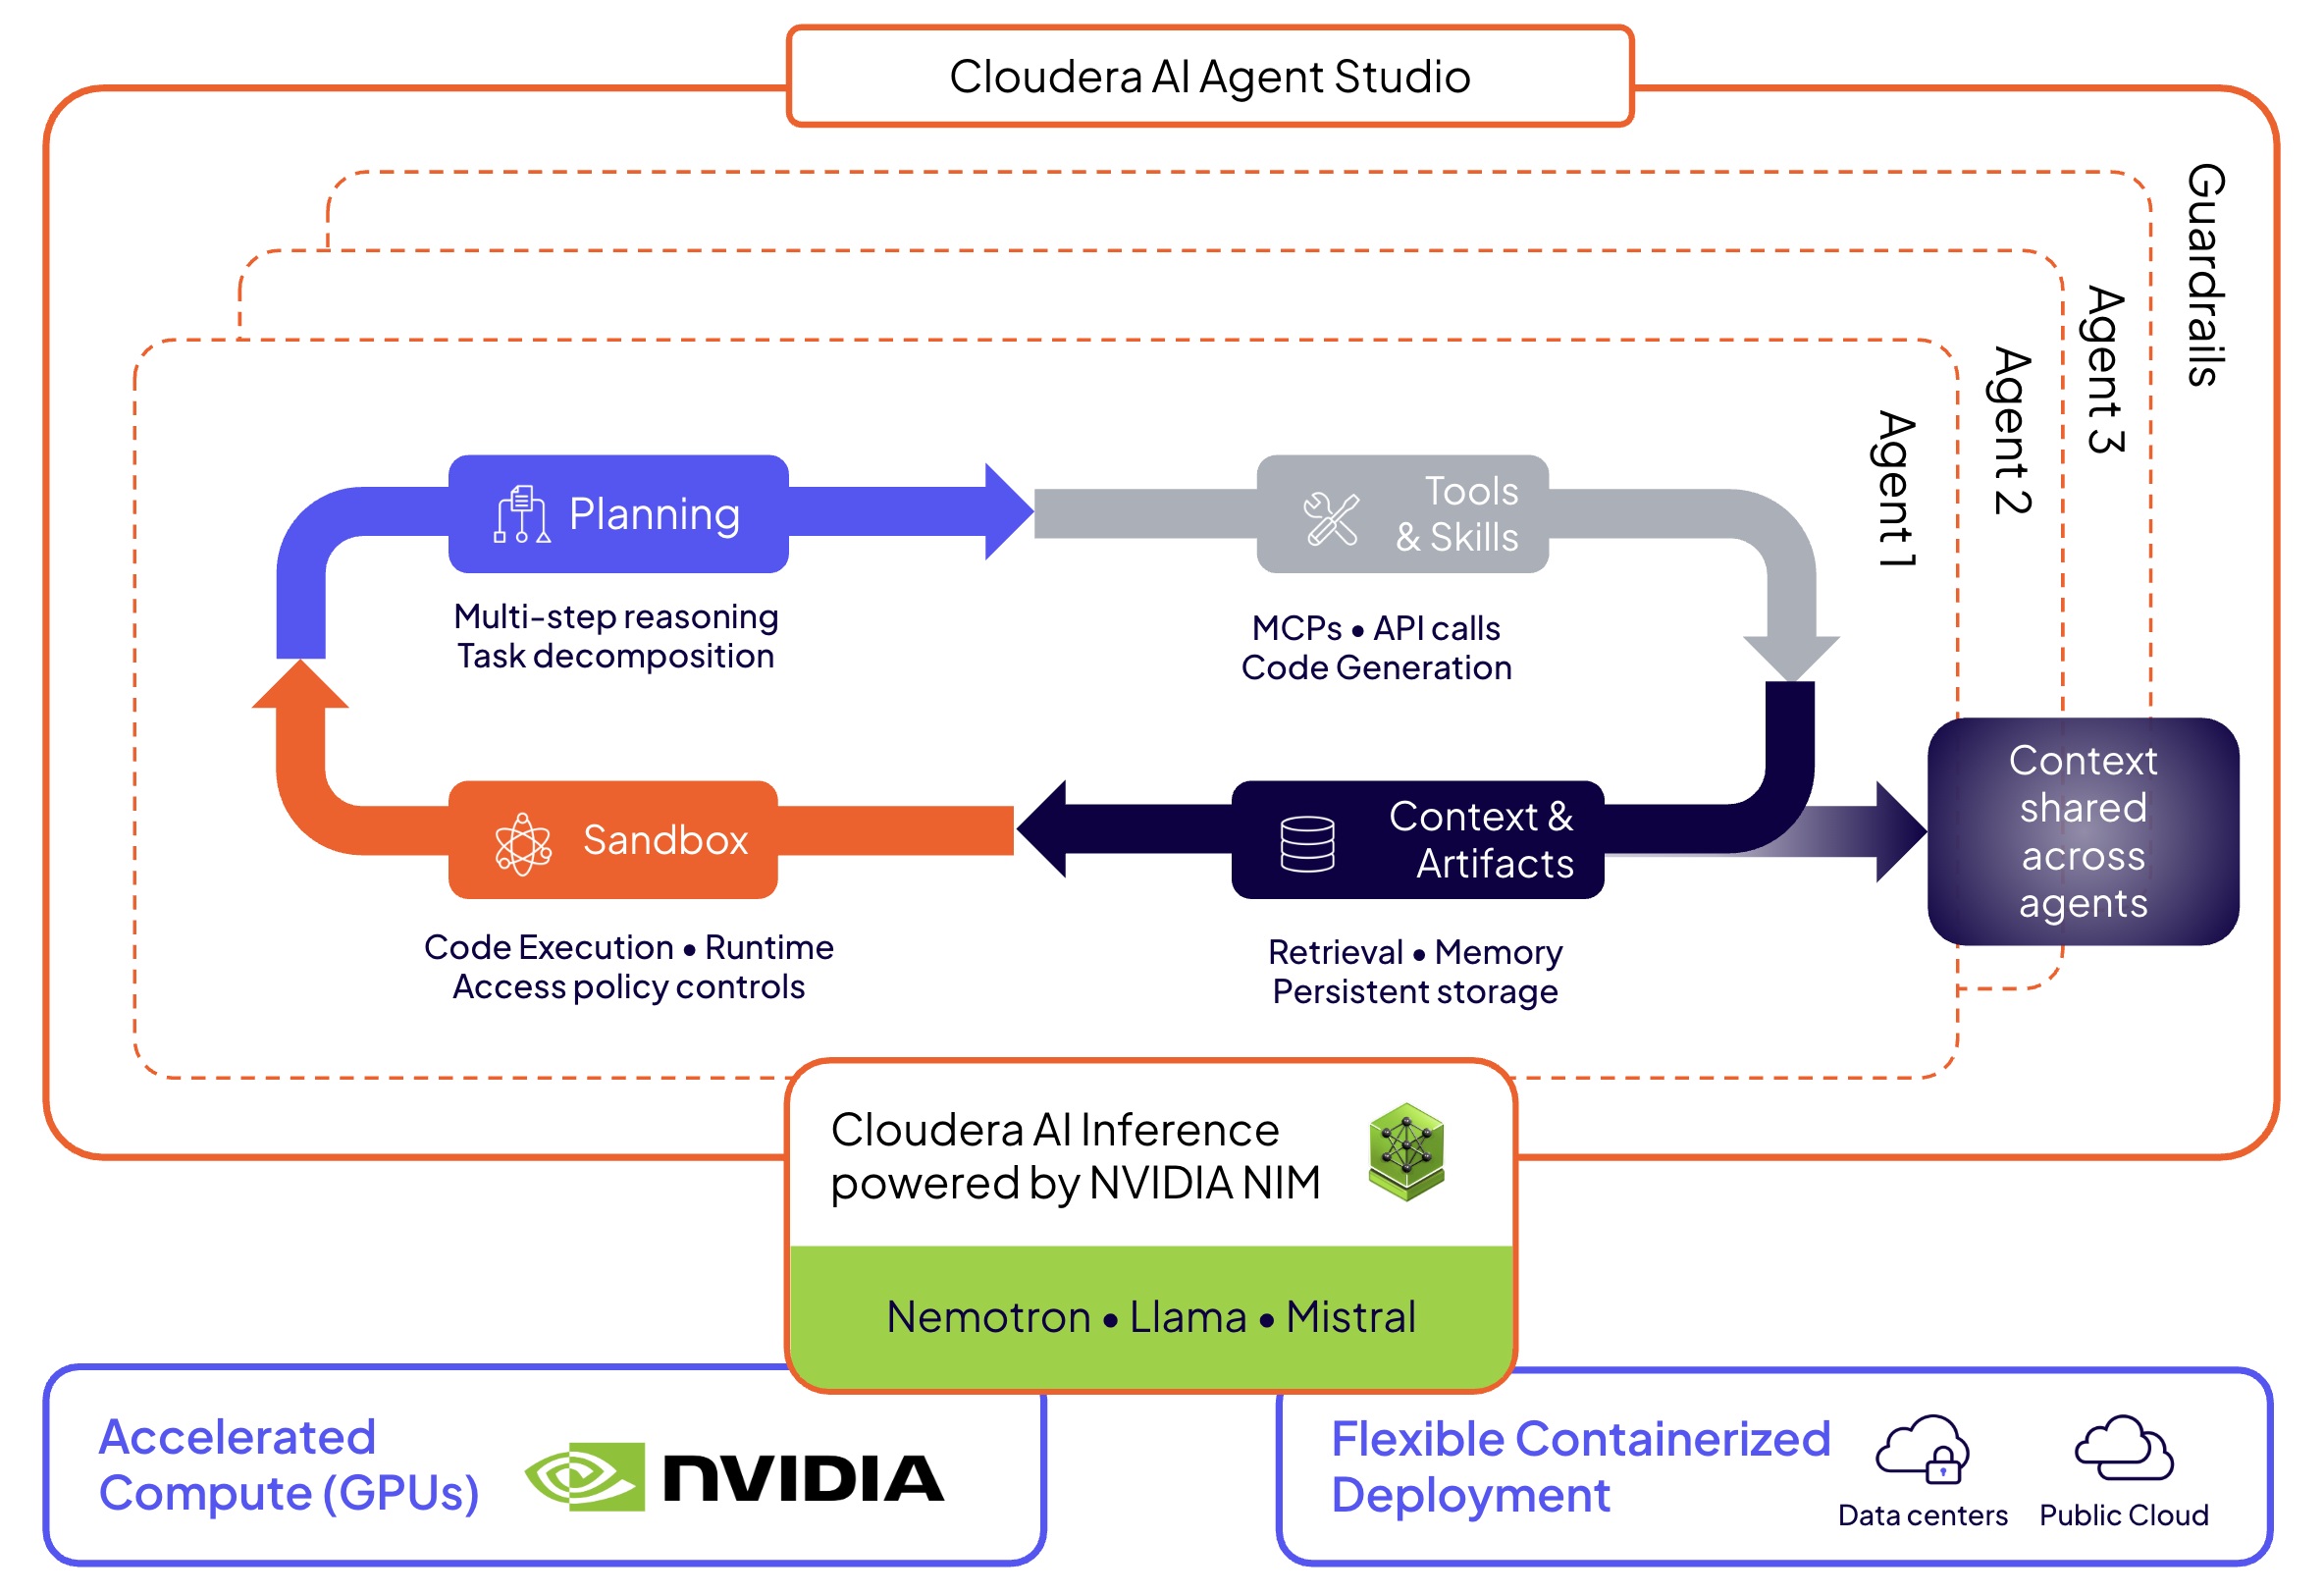 Architektur von Agent Studio 3.0
Cloudera Agent Studio 3.0 bewältigt diese strukturellen Herausforderungen, indem es autonome KI-Workflows direkt dort ausführt, wo sich Ihre Daten befinden. Durch die Bereitstellung einer regulierten Ausführungs-Engine, die auf den bestehenden Grundlagen der Cloudera-Datendienste läuft, beseitigt sie systematisch jede der fünf strukturellen Hürden:
1. Unveränderliche Audit-Protokolle & Sicherheitsmaßnahmen
Probleme mit Blackbox-Autonomie und Audit-Haftungsrisiken lösen
Um regulatorische Risiken zu mindern und eine Black-Box-Ausführung zu eliminieren, werden Systemaktivitäten in strukturierten, schreibgeschützten Audit-Logs erfasst. Compliance-Teams erhalten eine End-to-End-Transparenz, die authentifizierte Benutzeridentitäten, mikrosekundengenaue Zeitstempel, Operationstypen, Ressourcenbezeichner, Prompt-Eingaben und spezifische Tool-Ausgaben erfasst.
Ansehen: Guardrails in Echtzeit im Einsatz
Die Ausführungssicherheit wird kontinuierlich durch die folgenden Echtzeitmechanismen gewährleistet:
PII-Masking: Anonymisiert vertrauliche Daten, bevor sie in das Kontextfenster des Modells übertragen werden.
Inhaltsfilter: Textbasierte deterministische Regeln, die vor Prompt-Injection schützen oder die Ausführung anhand von Schlüsselwörtern blockieren.
Inline-LLM-Richter: Validiert Eingaben und Ausgaben von Tool-Payloads anhand unternehmensweiter Compliance-Regeln.
Benutzerdefinierte Leitplanke: Setzt programmgesteuert Leitplanken durch, die auf Ihre Geschäftsanforderungen zugeschnitten sind.
Weitere Details finden Sie in unserer Guardrails-Dokumentation.
2. Einheitliche Dual-Track-Workflows
Governance-Drift in Teams mit Silostrukturen beheben
Agent Studio 3.0 vereint die fachliche und technische Entwicklung auf einer einzigen Orchestrierungs-Engine und überbrückt die architektonische Trennung zwischen Business- und Engineering-Teams:
Für Business-Analysten: Erstellen Sie Workflows visuell mithilfe eines Katalogs vorkonfigurierter Tool-Vorlagen und MCP-Konnektoren.
Für KI-Ingenieure: Schreiben Sie benutzerdefinierte Python-Logik in Cloudera AI Workbench.
Da beide Pfade in identische Laufzeitumgebungen kompiliert werden, nutzen sie dieselben Sicherheitskontrollen der Plattform und beseitigen Abweichungen bei der Governance von Shadow AI.
3. Kontrollierbare Funktionsaufrufe und Sandboxing
Probleme mit fragilem Prompting und Ausführungswiederholungen beheben
Um fragile Ausführungsketten für Text-Prompts zu beseitigen, nutzt die Plattform native LLM-Funktionsaufrufprotokolle. Die Plattform übergibt dem Modell formale JSON-Schemas, um stark typisierte Tool-Aufrufobjekte zu generieren.
Container-Sandboxing: Jeder Agentenprozess wird in isolierten Container-Sandboxes ausgeführt, die standardmäßig keinerlei Systemberechtigungen aufweisen. Eine Rechteerweiterung erfordert die ausdrückliche Genehmigung einer Richtlinie auf Plattformebene.
Strukturierte Planung: Vor der Ausführung erstellen Agenten einen strukturierten Aufgabenplan, damit Operatoren den Fortschritt Schritt für Schritt deterministisch überwachen können.
4. Lokales Computing auf verwalteten Daten über MCP
Cloud-Egress-Gebühren und Token-Inflation lösen
Agenten werden direkt auf Unternehmensspeichern ausgeführt, ohne dass Daten extrahiert oder repliziert werden. Agenten fragen strukturierte Analysen in Cloudera Data Warehouse ab, verarbeiten Streaming-Eingaben über Cloudera DataFlow und übertragen Ergebnisse an Cloudera Data Visualization.
Konnektoren, die das Model Context Protocol (MCP) verwenden, binden Agenten direkt an offene Tabellenformate, während die Governance-Richtlinien von Cloudera Shared Data Experience (SDX) rollenbasierte Zugriffskontrollen durchsetzen und Metadaten bei jeder Interaktion nachverfolgen – so bleiben die Daten fundiert und die Egress-Gebühren bei null.
5. Modellneutralität & FinOps-Steuerung
API-Abhängigkeit und feste Rechenkosten lösen
Agent Studio 3.0 trennt die Orchestrierung vollständig von den zugrunde liegenden Sprachmodellen. Teams können APIs von Drittanbietern (OpenAI, Anthropic, Amazon Bedrock) ansteuern oder Open-Source-Modelle lokal über den Cloudera AI Inference Service bereitstellen.
Der Wechsel von Modellzielen erfordert die Aktualisierung von Endpunktkonfigurationen in der Orchestrierungsebene, ohne dass der Agentencode oder die Tool-Schemas geändert werden müssen. Systemarchitekten senken die Gesamtbetriebskosten (TCO), indem sie routinemäßige, hochvolumige Funktionsaufrufe an kleinere, lokal gehostete Parametermodelle weiterleiten und kostspielige API-Tokens von Drittanbietern ausschließlich für komplexe, mehrstufige Argumentationsaufgaben reservieren.
Quantifizierte Geschäftsergebnisse
Branche |
Betriebsszenario |
Geschäftswert |
Finanzdienstleistungen |
Bewerten Sie Geschäftskonten mit geringer Datenbasis über Datensätze hinweg, die mehr als 100 Millionen Einträge enthalten. |
Verkürzt Underwriting-Zyklen von Tagen auf Minuten und erstellt dabei aufsichtsbehördenkonforme Audit-Trails. |
Telekommunikation |
Verarbeiten Sie über 50.000 Streaming-Ereignisse pro Sekunde über Data Flow, um Abwanderungssignale zu erkennen. |
Löst in Echtzeit automatisierte Workflows zur Datenaufbewahrung aus, ohne Daten aus operativen Systemen zu verschieben. |
Gesundheit und Life Science |
Extrahieren Sie Diagnosecodes aus unstrukturierten klinischen Aufzeichnungen in verschiedenen Patientenakten. |
Beschleunigt die Datenverarbeitung klinischer Studien in netzwerkisolierten Laufzeitumgebungen. |
Versicherungen |
Korrelieren Sie unstrukturierte Vor-Ort-Erhebungen zu Immobilien mit zentralen Transaktionsdatenbanken. |
Identifiziert nicht berücksichtigte Risikofaktoren und automatisiert den systemübergreifenden Datenabgleich. |
Software & Technologie |
Führen Sie die Triage von Produktionsvorfällen der Stufe 2 innerhalb von Sandbox-Container-Laufzeitumgebungen durch. |
Behebt Anwendungswarnungen und aktualisiert Systemzustandsparameter, ohne dass eine Eskalation an einen Menschen erforderlich ist. |
Ihre Zukunft mit Governance-konformer agentischer KI
Der Übergang autonomer Workflows von isolierten Prototypen zu Produktivsystemen erfordert, die Spannungen zwischen schneller Innovation und unternehmerischer Kontrolle aufzulösen. Viel zu lange zwang die Kluft zwischen Proof-of-Concept und Bereitstellung Teams dazu, sich zwischen der Agilität autonomer KI und der Sicherheit einer zentralisierten Governance zu entscheiden.
Cloudera Agent Studio 3.0 schließt diese Lücke.
Indem Agent Studio 3.0 Rechenleistung direkt dort ausführt, wo sich die Daten befinden, beseitigt es systematisch die fünf größten Hindernisse für produktionsreife KI: Cloud-Egress-Gebühren, fragile Ausführung, Governance-Abweichungen, Unklarheiten bei Audits und Compute-Lock-in. Für die Bereitstellung agentischer KI in Unternehmen ist kein architektonischer Kompromiss mehr erforderlich.
Sind Sie bereit, Ihre KI-Agenten in die Produktion zu überführen? Holen Sie sich die Strategien und Kompetenzen, um in unserer 7-teiligen Webinar-Reihe zu Unternehmens-KI und agentischer KI den Schritt von der Entwicklung zur Produktion zu machen.